Les 5 étapes d’un PRA efficace en pratique
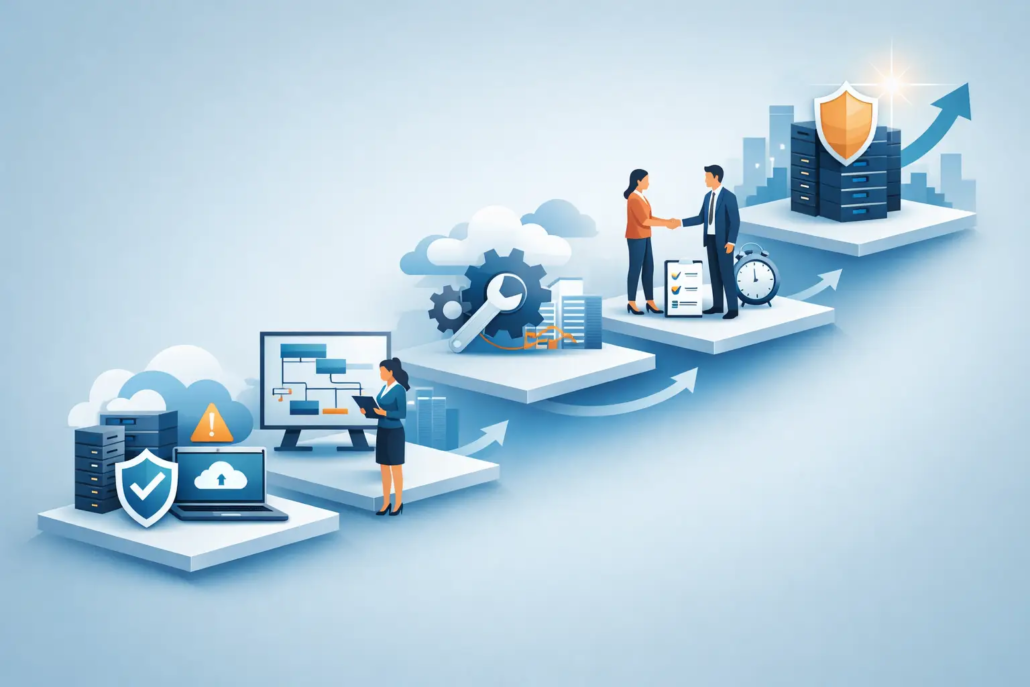
Lorsqu’une application critique devient indisponible, la qualité d’un plan de reprise d’activité ne se mesure pas à son volume documentaire, mais au délai et aux conditions réelles de retour au service. Les 5 étapes d’un PRA efficace permettent de transformer une intention de reprise en dispositif opérationnel, gouverné et vérifiable. Elles imposent un travail conjoint entre métiers, DSI, cybersécurité, risques et direction, car un PRA ne couvre pas seulement une infrastructure : il protège une capacité à délivrer un service essentiel.
Le PRA constitue un volet du dispositif global de continuité d’activité. Là où le PCA traite la continuité des activités critiques dans leur ensemble, le PRA organise spécifiquement la restauration des systèmes, applications, données et ressources techniques après une interruption majeure. Cette articulation est déterminante : un système peut être techniquement restauré sans que le métier soit réellement en mesure de reprendre son activité.
Les 5 étapes d’un PRA efficace
1. Cadrer le périmètre à partir des impacts métier
Un PRA utile commence par une compréhension factuelle des activités à protéger. Il ne faut pas partir des outils disponibles, ni reproduire une architecture existante dans un document de crise. Le point de départ est l’analyse d’impact sur l’activité, ou BIA, qui identifie les processus critiques, leurs dépendances, les conséquences d’une indisponibilité et le niveau de dégradation acceptable dans le temps.
Cette analyse doit relier chaque activité prioritaire aux composants nécessaires à sa réalisation : applications, bases de données, flux d’échanges, identités, postes de travail, réseaux, prestataires, sites d’hébergement et compétences clés. Les dépendances indirectes sont souvent celles qui fragilisent le plus la reprise. Une application de production peut être redémarrée, mais rester inutilisable si le service d’authentification, un flux bancaire, une interface de supervision ou un fournisseur SaaS demeure indisponible.
Le cadrage doit également préciser les scénarios retenus. Panne d’un centre de données, indisponibilité d’un fournisseur cloud, corruption de données, cyberattaque avec chiffrement, rupture réseau ou incident énergétique n’appellent pas tous la même réponse. Un plan conçu uniquement pour un sinistre physique sera insuffisant face à un ransomware ayant compromis les sauvegardes et les comptes à privilèges. Le niveau de couverture dépend du profil de risque de l’organisation et de ses obligations réglementaires ou contractuelles.
2. Définir des objectifs de reprise cohérents et arbitrés
Les objectifs de reprise traduisent les besoins métier en exigences opérationnelles. Le RTO, ou délai maximal de reprise, fixe le temps admissible avant le retour d’un service. Le RPO, ou perte de données maximale admissible, définit la profondeur de restauration acceptable. Ces indicateurs ne doivent pas être choisis par convention ni imposés uniformément à l’ensemble du système d’information.
Un RTO de quatre heures et un RPO proche de zéro impliquent des capacités techniques, contractuelles et humaines coûteuses : redondance, réplication, supervision, procédures accélérées, astreinte et tests fréquents. À l’inverse, accepter une reprise sous plusieurs jours peut être cohérent pour un outil de support non critique. L’enjeu est de documenter les arbitrages, d’en faire valider les hypothèses par les propriétaires métier et de démontrer que la stratégie retenue est proportionnée aux impacts.
Ces objectifs doivent être complétés par des critères de reprise. Reprendre ne signifie pas seulement rendre une application accessible. Il faut préciser les données de référence requises, les volumes minimaux à traiter, les contrôles de sécurité, les validations fonctionnelles et les conditions de retour à un fonctionnement normal. Dans certains cas, une reprise en mode dégradé est préférable à une attente prolongée d’un service totalement restauré.
3. Concevoir une stratégie de reprise réaliste
La stratégie de reprise décrit les moyens mobilisés pour atteindre les objectifs définis. Elle peut reposer sur des sauvegardes restaurables, un site de secours, une infrastructure en cloud, une réplication entre zones, des environnements de repli ou une combinaison de ces dispositifs. Le choix n’est jamais uniquement technologique : il engage les coûts, les compétences internes, les contrats fournisseurs, les contraintes de souveraineté et la capacité à opérer sous pression.
Pour chaque composant critique, il convient d’identifier la méthode de restauration, l’ordre de redémarrage, les prérequis et les points de contrôle. L’architecture cible doit aussi intégrer les risques de propagation. En contexte cyber, restaurer rapidement un environnement compromis ne constitue pas une reprise. Des sauvegardes isolées, des environnements propres, une vérification de l’intégrité des données et une gestion maîtrisée des accès à privilèges sont nécessaires avant toute remise en production.
La stratégie doit traiter les capacités rarement prises en compte dans les schémas techniques : bande passante de restauration, licences disponibles, délais d’approvisionnement, accès aux coffres de mots de passe, ressources de stockage, capacités de traitement et disponibilité des équipes. Une solution de secours annoncée comme disponible en quelques heures doit pouvoir le prouver dans les conditions opérationnelles prévues, y compris lorsqu’un prestataire est simultanément sollicité par plusieurs clients.
4. Formaliser des procédures activables et une gouvernance claire
Un PRA est activé dans un contexte d’incertitude, souvent avec des équipes réduites et des informations incomplètes. Les procédures doivent donc être précises sans devenir illisibles. Elles définissent les critères d’activation, les rôles, les circuits d’escalade, les actions de restauration, les contrôles techniques, la validation métier et les modalités de communication.
Chaque action critique doit être attribuée à un rôle, avec un suppléant identifié. Il est préférable de distinguer clairement la cellule de décision, qui qualifie l’incident et arbitre les priorités, des équipes d’exécution, qui restaurent les services. La gestion de crise et la communication interne ou externe doivent être coordonnées avec le PRA, sans confondre les responsabilités. Une décision de reprise peut avoir des conséquences sur la sécurité, la conformité, la relation client et l’image de l’organisation.
Les documents opérationnels gagnent à intégrer des informations immédiatement exploitables : coordonnées de contacts, accès aux outils, dépendances, séquences de démarrage, commandes ou scripts validés, critères d’acceptation et modèles de compte rendu. Ils doivent néanmoins rester protégés et accessibles en cas d’indisponibilité du système d’information habituel. Un plan hébergé uniquement sur l’environnement qu’il doit permettre de restaurer présente une faiblesse évidente.
5. Tester, mesurer et maintenir le dispositif
Un PRA non testé est une hypothèse. Les exercices vérifient non seulement la restauration technique, mais aussi la disponibilité des personnes, la qualité des procédures, la pertinence des dépendances recensées et la capacité de décision. Ils révèlent fréquemment des écarts simples mais bloquants : compte de service expiré, procédure obsolète, sauvegarde incomplète, ordre de redémarrage erroné ou fournisseur indisponible.
La progression des tests peut être graduelle. Une revue documentaire permet de vérifier la cohérence du plan ; un exercice sur table évalue la coordination ; un test technique contrôle une restauration ciblée ; un exercice de bascule apporte une validation plus complète. Le niveau d’ambition doit être adapté à la criticité, au risque acceptable et à la capacité de l’organisation à supporter une perturbation contrôlée. Pour les services les plus critiques, seuls des tests proches des conditions réelles peuvent valider le respect du RTO et du RPO.
Après chaque exercice ou incident, un retour d’expérience formalisé est indispensable. Les écarts doivent être priorisés, affectés à des responsables et suivis jusqu’à leur clôture. La maintenance du PRA doit aussi être déclenchée par les changements significatifs : évolution d’architecture, migration cloud, nouveau prestataire, transformation d’un processus métier, modification des exigences de sécurité ou départ d’un expert clé.
Faire du PRA un dispositif de résilience piloté
La maturité ne repose pas sur l’existence d’un plan, mais sur la capacité à démontrer qu’il est aligné sur les impacts métier, finançable, activable et régulièrement éprouvé. Des indicateurs simples peuvent soutenir ce pilotage : taux de couverture des services critiques, conformité des tests au calendrier, écarts ouverts, atteinte des RTO et RPO, ou actualisation des procédures après changement majeur.
Les référentiels de continuité d’activité, notamment l’ISO 22301, apportent un cadre utile pour inscrire ces pratiques dans une gouvernance durable. Ils ne remplacent pas l’expertise opérationnelle, mais ils aident à structurer les responsabilités, les preuves et l’amélioration continue. La professionnalisation des équipes reste alors un facteur déterminant : face à un incident majeur, la méthode et la préparation font la différence entre une reprise subie et une reprise maîtrisée.
La prochaine revue de PRA peut ainsi devenir un exercice de décision concret : pour chaque service critique, l’organisation est-elle capable de prouver, par des résultats de test, comment elle reprendrait, avec quelles données et sous quelle autorité ?
Cet article est également disponible en :


